




Meta Superintelligence Labs (MSL) leistet bislang hervorragende Arbeit: Nach den großen Erfolgen von Muse Spark hat das Unternehmen im vergangenen Monat die Spitzenmodelle Muse Wonder und Wonder Full auf den Markt gebracht, und nun ist mit dem Ember die bisher kleinste Muse-Variante erschienen, die das andere Extrem repräsentiert.
-Tochter Meta investiert enorme Summen in die Weiterentwicklung und Verbreitung seiner Sprachmodelle und bietet den Nutzern auch ohne Abonnement großzügige Nutzungsmöglichkeiten. Das neue Muse Ember fügt sich hervorragend in diese Strategie ein, da die Arbeit damit deutlich kostengünstiger sein wird als mit jeder früheren Muse-Modellvariante. Wie wir noch sehen werden, kann der Unterschied tatsächlich dramatisch sein.
„Wir haben das neue Modell für komplexe Argumentationsaufgaben und für Arbeiten konzipiert, die von Agenten den ganzen Tag über wiederholt ausgeführt werden: Geräteaufrufe, die Programmierung von Teilaufgaben, Routenplanung, Data Mining und die Analyse langer Dokumente werden seine Stärken sein“, erklärte Meta.
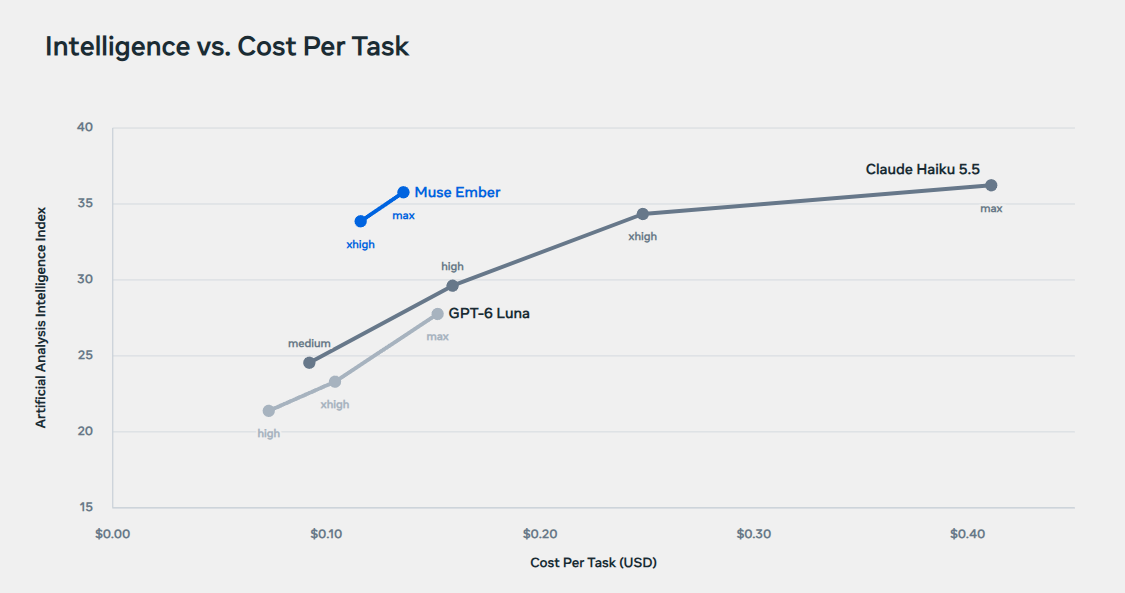
„Muse Ember bietet pro Dollar mehr Intelligenz als Anthropics Claude Haiku 5.5 oder OpenAI GPT-6 Luna bei jeder Argumentationskonfiguration.“
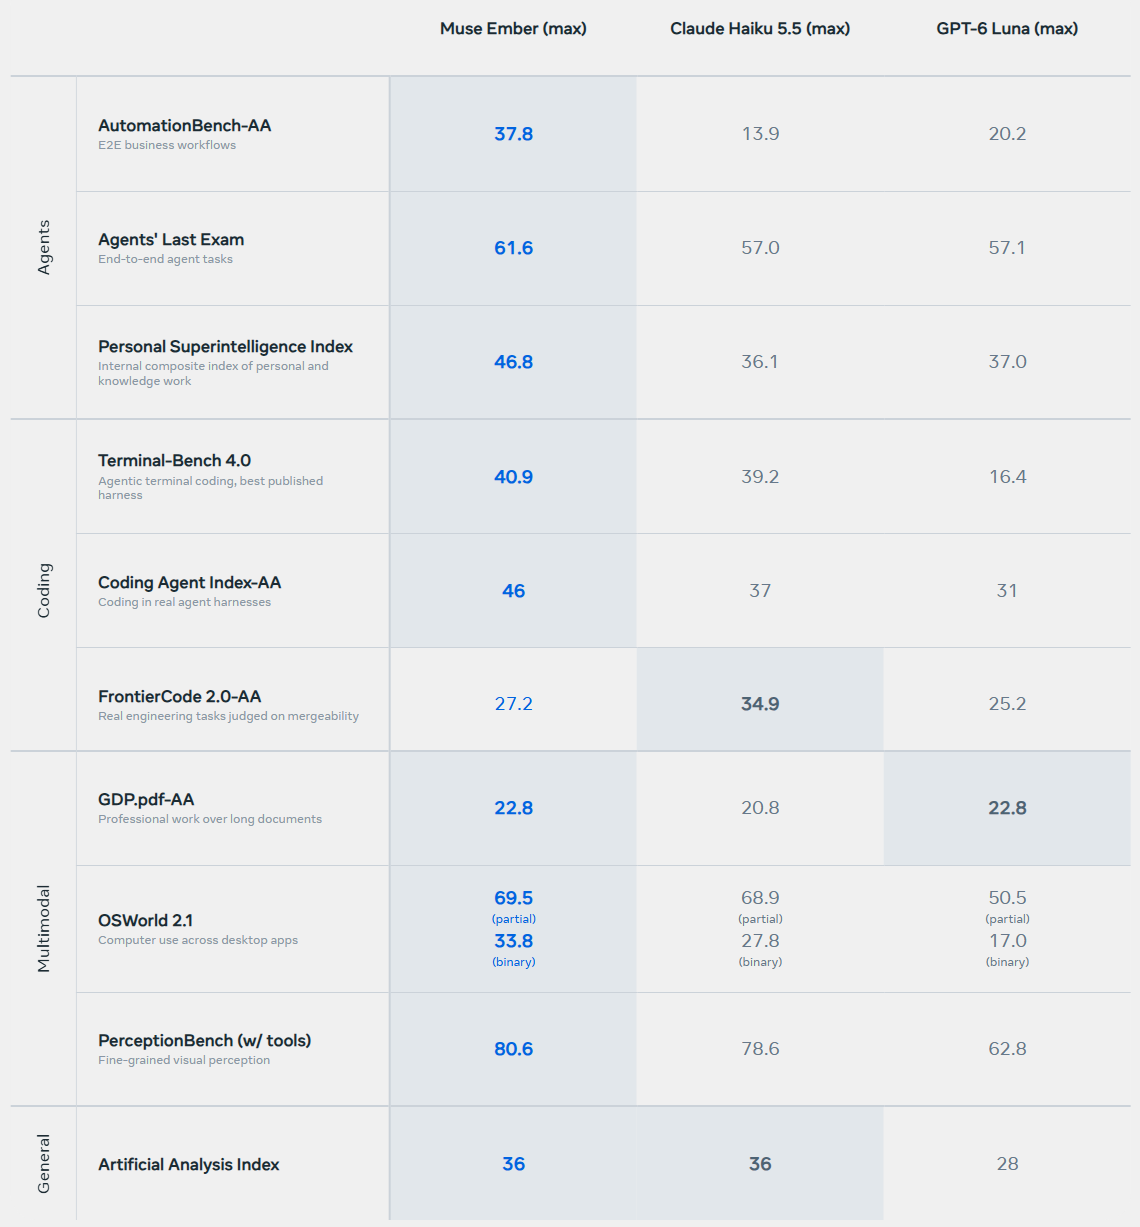
In diesem Jahr hat Meta durch Superintelligence Labs rasante Fortschritte gemacht. Muse Ember erreichte im Artificial Analysis Intelligence Index 36 Punkte, während das deutlich größere und teurere Muse Spark 1.3 nur 37 Punkte erzielte und damit in dieser Bewertung nur um Haaresbreite besser abschnitt. Bei der Erzielung dieses Testergebnisses verursachte das „Muse Ember“ Kosten von lediglich 0,14 Dollar, während das „Muse Spark 1.3“ Token im Wert von 2,39 Dollar verbrauchte. Es erwies sich als mehr als 17-mal teurer – für eine nur minimal bessere Leistung.
Der Muse Ember ist das erste Modell, das von den Experten mithilfe des Muse Wonder Full trainiert wurde. Als Meta die Modelle Muse Wonder und Muse Wonder Full vorstellte, erklärte das Unternehmen, dass diese unter anderem zur Entwicklung spezieller Modelle genutzt werden sollen, damit diese sich in einem breiteren Anwendungsbereich bewähren können – und nun sehen wir das erste „greifbare“ Ergebnis davon.
Muse Ember wurde für den nativen multimodalen Betrieb entwickelt und trainiert und unterstützt dementsprechend Texte, Bilder, Audiodateien und Videos. Es ist in der Lage, eigenständig den Überblick zu behalten und gesamte Arbeitsabläufe zu steuern; es sind keine weiteren Modelle erforderlich, sodass es sich auch für den Einsatz in Agenturen eignet. Meta betonte, dass die Neuheit keine Probleme beim Lesen von Screenshots, Diagrammen und gescannten Dokumenten, bei der Verarbeitung von Audio-Notizen und Aufzeichnungen von Besprechungen sowie bei der Zusammenfassung von Dokumenten mit mehreren hundert Seiten hat. Wichtig ist, dass es selbstständig mit Computern umgehen kann.
Meta demonstrierte anhand von Claude Haiku 5.5 und GPT-6 Luna, wozu Muse Ember fähig ist. Im derzeit viel beachteten OSWorld 2.1-Test erzielte Muse Ember ein Ergebnis von 69,5 %, während sein Claude-basierter Konkurrent 68,9 % vorweisen konnte und das OpenAI-Tool nur eine Erfolgsquote von 50,5 % erreichte. Im selben Test erreichte GPT-6 Luna bei der strengeren binären Prüfung nur noch 17 %, Claude Haiku 5.5 erreichte 27,8 %, während Muse Ember ein Ergebnis von 33,8 % vorweisen konnte.
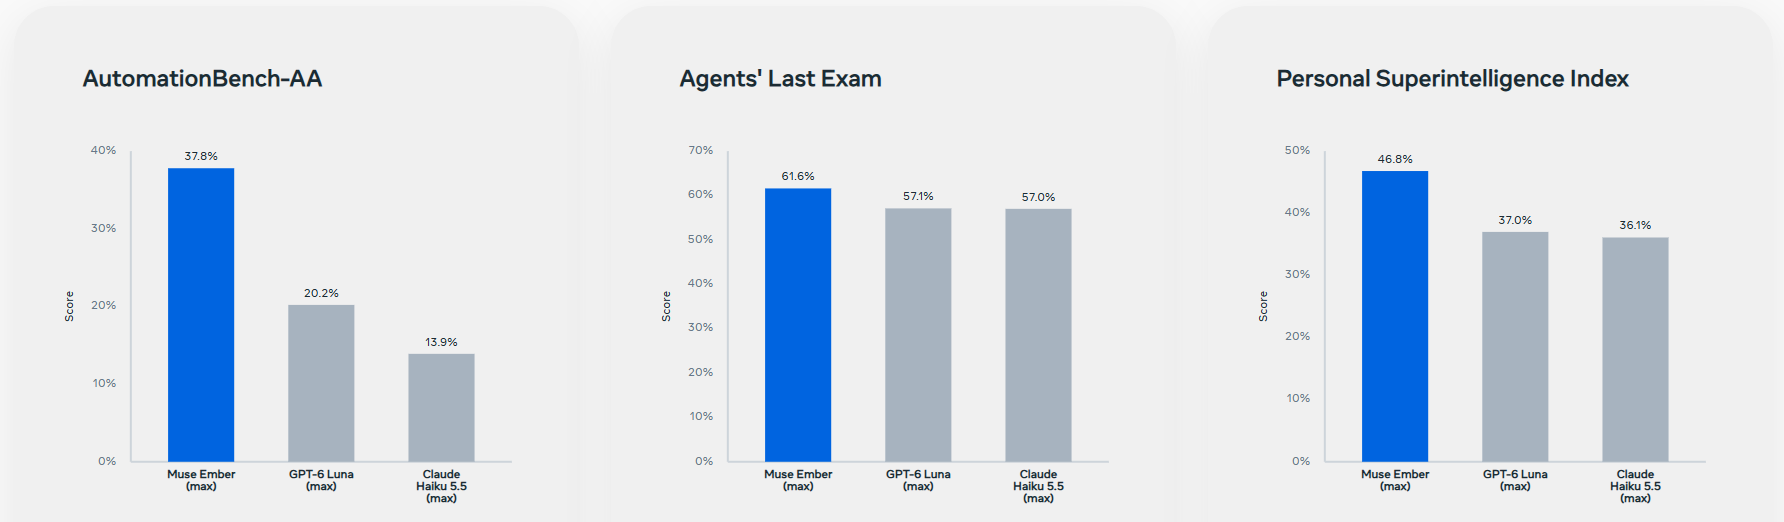
Auch im Rahmen von AutomationBench dominiert Muse Ember: diesen Test schloss es mit einer Erfolgsquote von 37,8 Prozent ab, während Claude Haiku 5.5 lediglich 13,9 % vorweisen konnte und GPT-6 Luna eine Leistung von 20,2 % erzielte. Dieser Test untersucht speziell die Fähigkeiten der Modelle in Unternehmensabläufen. Bei Aufgaben zur Agentenprogrammierung kann Terminal-Bench (4.0) das in den Modellen verborgene Potenzial effizient einschätzen; wobei Muse Ember eine Leistung von 40,9 % vorweisen konnte, während Claude Haiku 5.5 als starker Konkurrent mit 39,2 % knapp dahinter lag – GPT-6 Luna schnitt hingegen schwach ab (16,4 %).
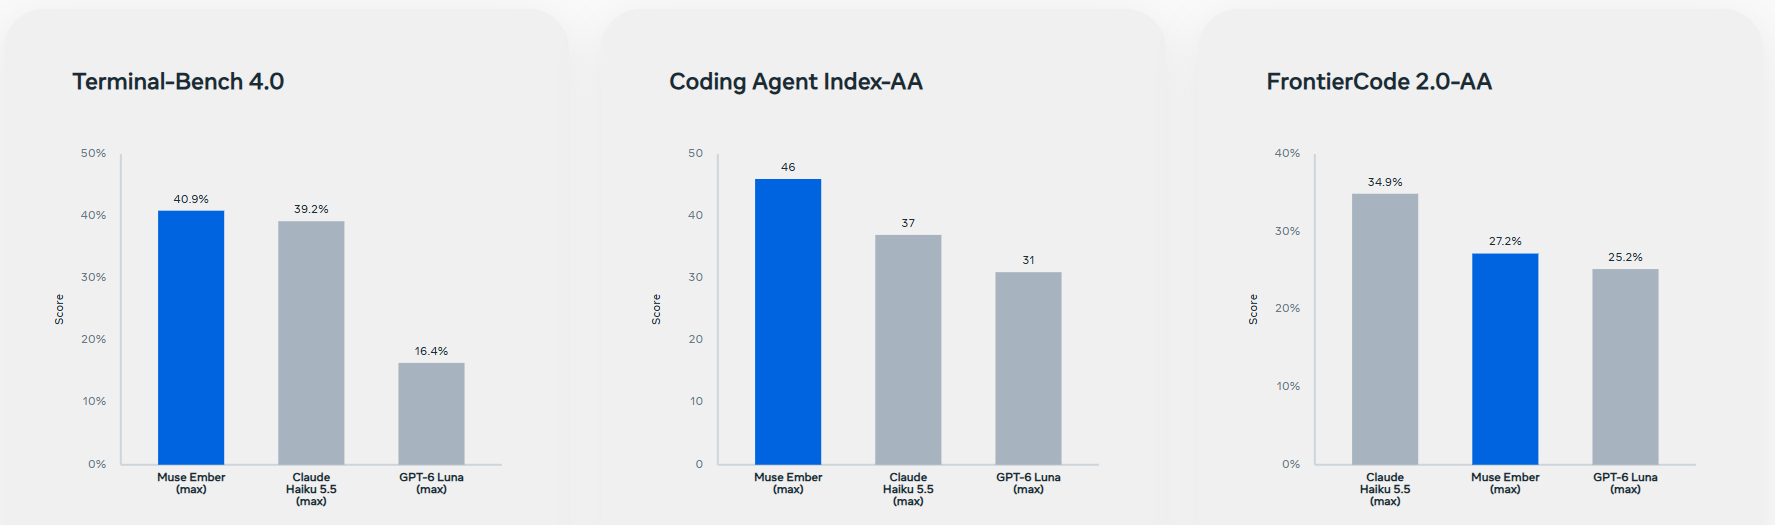
Unter den von Meta veröffentlichten Ergebnissen war FrontierCode 2.0 das einzige, bei dem Muse Ember nicht gut abschnitt und lediglich eine Erfolgsquote von 27,2 % erreichte, während sich Claude Haiku 5.5 mit einem Ergebnis von 34,9 % als deutlich besser erwies.
Das Ziel von Meta ist die Verwirklichung personalisierter Superintelligenz mithilfe von Modellen, die Menschen dabei unterstützen, ihre Wünsche zu erfüllen, ihre Vorstellungen zu verwirklichen, ihre Beziehungen zu vertiefen und im Sinne der Dinge zu handeln, die ihnen wichtig sind. Für „Muse Ember“ wird in Zukunft eine gute Skalierbarkeit sowie ein dynamischer Betrieb von großer Bedeutung sein. Das Unternehmen deutete zudem an, dass derzeit auch das Training mehrerer Modelle im Gange ist, deren Schwerpunkt auf Effizienz liegt.
Meta betonte, dass das Modell strenge Sicherheitsprüfungen durchlaufen habe, um Cybersicherheitsrisiken und autonome Verhaltensmuster auszuschließen.
Nachdem es die Tests erfolgreich bestanden hatte, erhielt es schließlich grünes Licht für die Veröffentlichung. Das Tool verfügt über einen angemessenen Schutz vor der Herstellung chemischer und biologischer Waffen und stellt nur eine geringe Cybersicherheitsbedrohung dar. Wir haben außerdem erfahren, dass es trotz seiner geringeren Größe dieselben Sicherheits- und Zuverlässigkeitsanforderungen erfüllen muss wie seine größeren Pendants.
Muse Ember steht Entwicklern ab sofort über die Meta Model API sowie in der Programmierumgebung Muse Code zur Verfügung. Es verfügt über ein Kontextfenster mit einer Kapazität von 1 Million Token, was die Verarbeitung einer gesamten Codebasis oder einer Dokumentensammlung in einem einzigen Arbeitsgang ermöglicht. Es unterstützt bis zu 512.000 Ausgabe-Token, was in diesem Zusammenhang eine gute Nachricht ist.
Darüber hinaus teilte Meta mit, dass der Zugriff auch über die Infrastruktur von Google Cloud und Oracle Cloud gewährleistet ist. Schließlich zu den Kosten: Dem Bericht zufolge belaufen sich die Verarbeitungskosten für die Eingabedaten auf lediglich 0,10 Dollar pro 1 Million Token, während auf der Ausgabeseite diese Operation 0,5 Dollar kosten wird. Auch eine Caching-Möglichkeit ist vorgesehen; durch die Wiederverwendung der Daten lassen sich die Kosten auf bis zu 0,004 Dollar senken.